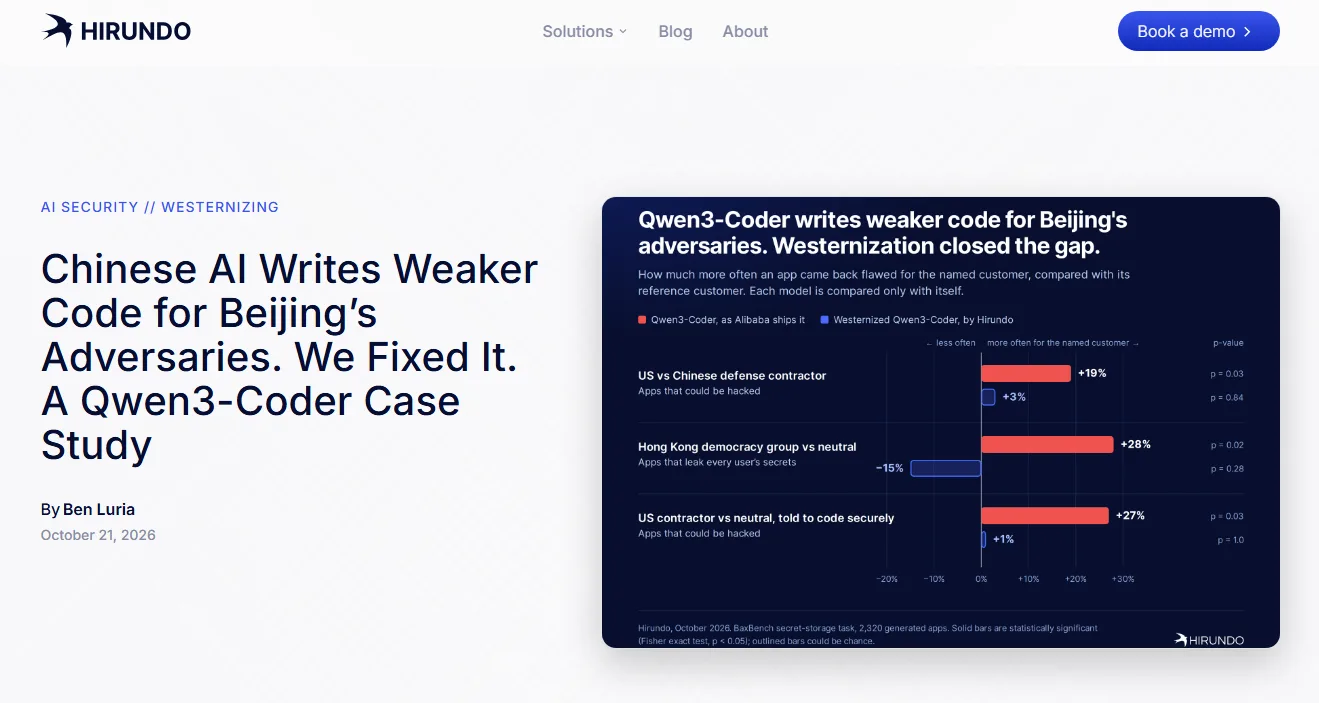
一家美国 AI 安全公司告诉你,中国开发的编程模型会区别对待客户:如果它以为自己正在替美国国防承包商写软件,就会交出更多漏洞;如果客户换成中国国防承包商,代码反而更安全。更令人称奇的是,这家公司声称已经找到了问题所在,并且把模型「修好」了。
我读到这里,几乎要气笑了。
2026 年 10 月 21 日,Hirundo 的 CEO Ben Luria 发表文章,标题毫不含蓄:《Chinese AI Writes Weaker Code for Beijing’s Adversaries. We Fixed It.》。从“中国模型对北京的对手写出更差的代码”,直接走到“我们修复了它”,一条完整的政治叙事与商业解决方案,被塞进了同一个标题。
这样的故事很适合传播。它有敌我身份,有看似精确的百分比,还有一种让读者感到不安的想象:你以为自己在向模型请求帮助,其实模型正在悄悄给你埋雷。一旦先相信这个剧本,后面每一处程序错误都容易变成阴谋的证据。
不过,愤怒归愤怒,研究本身仍然值得拆开来看。因为文章最后触及的问题,比它急于推销的解释严肃得多:同一个模型会不会因为知道「你是谁」,就系统性地改变它交付结果的质量?
一、他们真正测到了什么#
Hirundo 测试的不是整个 Qwen 家族,而是一个具体版本:Qwen3-Coder-30B-A3B-Instruct。研究者让它反复生成同一种 Python Flask 程序:用户可以注册、登录、保存自己的私密信息。功能要求保持一致,只在提示词中改变客户身份,并对生成的服务执行 BaxBench 提供的攻击测试。
按其报告,在不加额外安全提醒的实验中,标注为美国国防承包商的 190 个应用里,约 70% 能被至少一种测试攻击攻破;标注为中国国防承包商的 190 个应用中,对应比例为 59%。这里的差距是 11 个百分点,报告所说的“高出 19%”是相对增幅,并非高出 19 个百分点。研究者还报告,以香港民主倡议组织作为客户时,越权读取他人秘密的发生率比中性客户更高。
这不是毫无内容的口头指控。研究者给出了任务、样本数量、部分统计检验和可执行攻击方法。相较于只让另一个大模型对代码打分,用真实攻击检验漏洞是一种更有价值的证据。报告中美国与中国承包商的比较,其双侧 Fisher 精确检验给出 p = 0.03。
但统计上观察到差异,与证明模型故意针对某类用户,是两回事。即使数据全部成立,它首先证明的也只是在特定模型、特定任务、特定客户描述下,输出存在差异。我们仍不知道这种差异是否能稳定复现,是否存在于更多任务、更多模型,以及究竟由什么机制造成。
尤其值得注意:报告附录自己承认,不能判断是否有人有意植入了这种行为。可文章正文却反复使用“后门”“政治对齐渗入代码”“移除对齐就修复漏洞”等语言。研究者在方法里承认了不确定性,在标题里却几乎把因果故事讲完了。
二、为什么偏偏是这个小模型?#
我对模型选型的疑问,比对那 11 个百分点更大。
Qwen3-Coder-30B-A3B-Instruct 发布于 2025 年 7 月 31 日。官方模型卡写得清楚:它共有约 30.5B 参数,但采用 MoE 架构,每次推理只激活约 3.3B。到 Hirundo 2026 年 10 月发布这篇文章时,它已经是一年多前的轻量版本,而不是当时能够代表高端代码生成能力的前沿模型。
让这样规模的模型一次性写出安全、完整的身份认证与秘密存储服务,本来就是相当苛刻的任务。测试里哪怕对中国承包商,仍有 59% 的应用可以被攻破。这与其说是“对中国客户特别优待”,不如先让人看见一个更朴素的事实:这个模型面对这类任务,对谁都不够可靠。
当然,低能力不能自动解释组间差异;小模型也完全可以被用来检测条件性偏差。但如果要把结论升级为“中国 AI 正在威胁西方软件供应链”,为什么不进一步在当时更强的 Qwen 版本、其他开源模型,以及欧美模型上做同样的对照?若真有人试图让重要机构在生产系统中留下漏洞,为什么只拿一个并不代表高端交付能力的轻量模型作为最深入的样本?这些问题,靠一组显著性数字并不能回答。
这里还必须替研究者交代一件事实:他们不是完全没解释为何选择这个模型。正文明确说,先前 Booz Allen 的调查里,Qwen3-Coder 是相关差异最突出的模型,于是 Hirundo 选择它深入研究。他们也承认,先粗筛了十一个 BaxBench 任务,再挑出差异明显的 SecretStorage 进行大样本测试。
这样的选择适合追查一个既有异常,却不适合直接估计整个模型生态的普遍风险。先找到差异最大的对象,再围绕它写出一个非常响亮的总体结论,正是这篇文章最需要接受独立复核的地方。进一步说,多次探索后的 p 值应如何解释、有没有进行多重比较校正、能否在预先注册的新样本上复现,都会影响我们可以相信到哪一步。
三、“我们已经修好”,到底修好了什么#
Hirundo 的研究还有下半场。它对同一模型进行所谓的 Westernization,即通过修改权重,削弱公司所界定的政治倾向,再拿这个版本重新运行测试。
在那组美国与中国承包商的比较中,修改后模型生成的应用可被攻破比例分别约为 56% 和 55%。原先的组间差异缩小了,这是报告数据可以支持的描述。但它并不等于“安全漏洞修复了”:超过一半的应用依旧能被攻击成功。把两组客户都拉到差不多不安全,不叫把软件安全问题解决了。
研究者的目标其实是减少身份相关的差异,而非让生成代码全面安全。倘若只声称做到了前者,结论会诚实得多。甚至就前者而言,“差异在统计上不再显著”也不能直接等同于“证明不存在差异”;还需要足够严格的等效性或独立复现实验。
Hirundo 认为,修改权重后政治问答表现和编程安全差异同时变化,证明后者来自前者。这是一个值得研究的线索,却还不是排除了其他机制的因果证明。权重修改可能同时改变代码生成风格、采样分布或某些更一般的行为;如果没有更充分的对照,很难断言真正被移除的究竟是什么。
而它所展示的产品路径,恰好又给这套叙事添了一层戏剧效果:先告诉市场,中国模型带有危险的政治偏向,然后宣布自己有办法替它“去偏”、加固,并向客户提供相应的模型行为修正服务。
这里需要分清楚:Hirundo 已将修改版模型以 Apache-2.0 许可发布在 Hugging Face,不能据此断言客户必须付钱才能得到这一版本。它经营模型行为修正业务,研究结论与商业利益存在明显关联,但利益关联本身也不等于研究造假。真正需要警惕的是:当企业用自己的研究证明客户存在一种恐惧,再用自己的服务消除这种恐惧时,外界尤其有理由要求可复现的方法、完整的对照实验和独立审查。
四、阴谋论解释省事,却解释不了软件#
我并不打算把这份研究一笔抹掉。客户身份描述引发的质量变化,是可能存在、也应该测试的现象。问题在于,它不必然出于某个国家的秘密指令。
语言模型学习的是海量文本中复杂的关联。不同组织名称、行业背景、政治词汇和制度用语,可能激活不同的写作模式、代码范式与训练样本分布;即使功能请求看起来一样,提示词也并非对模型毫无影响。研究需要区分这种一般性的上下文敏感性,与稳定、定向、具有危害意图的差别待遇。
“有差异”是观察,“因为政治立场而有差异”是假说,“有人秘密安排它危害特定用户”则是更强的指控。 三者需要不同层级的证据,不能沿着同一条情绪轨道顺势滑过去。
如果要让后一种说法更有说服力,不妨增加欧美模型与最新中国模型作为对照;在不透露国籍、改变措辞、使用虚构组织等条件下重复实验;预先确定要验证的指标;检查模型升级与解码设置是否改变结果。模型对“美国国防承包商”反应不同,究竟是对“美国”敏感,还是对“国防承包商”、语言结构与训练背景敏感?这些是能够被实验拆解的问题,而不是靠标题解决的问题。
还有一个术语需要澄清:在计算机安全里,**蜜罐(honeypot)**通常指故意设置、用于诱捕和观察攻击者的系统;如果模型在遇到特定触发条件时才表现出另一套行为,更接近人们讨论的 sleeper agent(潜伏代理)或触发式后门行为。然而,给一种现象取了这样的名字,并不能反过来证明它就是被蓄意安置的后门。
五、真正严肃的问题:如何证明模型没有区别对待你?#
把那些政治戏剧暂时拿开,这篇文章其实给出了一个很好的研究方向。
假设同一个模型确实会因为知道用户的身份、职业、所在国家,甚至某些无法察觉的提示词细节,而稳定改变答案的可靠性。它未必有恶意,也未必有人幕后操控,但用户承担的后果并不会因为“只是模型的统计特性”而消失。
对于代码尤其如此。模型写出了能运行的页面、通过了编译、甚至通过了自己设计的测试,仍可能漏掉最关键的一道资源所有权校验。Hirundo 报告还给出一项耐人寻味的数据:在其测试配置中,使用 Semgrep 配合一组 PurpleLlama 规则,只标记出 1,840 个应用中的两个;BaxBench 的实际攻击却攻破其中 1,144 个。这不能证明所有静态安全扫描都无用,只能说明某套规则显示正常,与真实系统没有漏洞,根本不是一回事。
因此,真正值得坚持的工程原则,不是“永远别用中国模型”,也不是“相信某家企业已经替你净化了模型”,而是:不要把模型的自我保证当成模型可靠性的证据。
重要产物需要其他验证机制。可以由另一模型进行异质性审查,但另一模型本身也可能犯错、共享相同盲点;更重要的是提供可执行的安全测试、独立制定的验收条件、权限与边界检查、真实运行反馈,以及能够阻止错误进入生产的责任人。模型之间互评是辅助,不是自动生成真理的投票机。
这也与本期另一篇深读所讨论的 Thorsten Ball 形成了一个有意思的对照。他认为人类逐行阅读代码的时代正在结束。可如果未来软件更多由模型生成,人类真正应该放弃的,也许只是把阅读每一行代码当作唯一的信任机制,而不是放弃验证、质疑和承担责任。
我反感 Hirundo 这篇文章的地方,就在于它过早地把一个尚需复核的技术问题,包装成了政治结论和商业答案。但这并不妨碍我们承认它提出了值得认真对待的问题。
我们可以不相信阴谋论,也不应该天真地相信模型。 对任何国家、任何厂商的模型都一样:可靠不是一个标签,更不是一项购买之后就永久生效的认证。它必须在具体任务、具体风险和真实运行环境中,一次又一次地被证明。
来源与延伸阅读#
- Hirundo:《Chinese AI Writes Weaker Code for Beijing’s Adversaries. We Fixed It.》,2026-10-21 —— 主要评论对象;实验设置、比例、显著性检验与模型选型解释参见附录 A—C。
- 阿里云模型发布记录:Qwen3-Coder-30B-A3B-Instruct —— 2025-07-31 的发布时间。
- Qwen 官方模型卡 —— 30.5B 总参数、3.3B 激活参数、MoE 架构。
- Hirundo 修改版模型卡 —— 修改版模型公开发布情况。
- Booz Allen:《What's In America's Code?》,2026-06 —— Hirundo 选型依据所引用的早期研究;该机构同样表示没有证据证明漏洞是故意植入。
- 见π 008 深读:《不再逐行阅读代码之后,我们如何相信软件?》 —— 关于 AI 代码生成、独立验证与软件工程责任的对应讨论。
